《Pose-guided Visible Part Matching for Occluded Person ReID》论文笔记
目录
Introduction
-
许多Re-ID的方法都假设了行人完整的身体都是可见的,然而在真实场景下,这样的假设很难被满足,行人可能会被其他行人、树木、车辆等遮挡。因此,一种能够有效地解决有遮挡情况下的Re-ID问题的方法是被迫切需要的。
-
有遮挡的Re-ID任务主要有以下两个挑战:
-
传统的基于全局图像监督的Re-ID方法所提取的特征不仅仅包括行人特征还包括了遮挡物的特征,而遮挡物的颜色形状等特征具有多样性,使得对于目标特征的描述难以具有很高的鲁棒性。
-
有些时候,被遮挡的部分包含了更多的有判别性的特征而未被遮挡部分在数据集中趋向同质,这会导致错误匹配的问题。
-
-
一种直观的解决思路是检测未被遮挡的部分,使用这一部分去匹配。然而由于标注中没有遮挡部分和未遮挡部分的信息,现有的方法只能借助一些在其他数据源上进行的身体分割、姿态估计等任务来完成。但是这样的方法有着巨大的跨域数据偏差问题,不能保证其他数据源上的模型能够在当前数据集下有良好的效果。
-
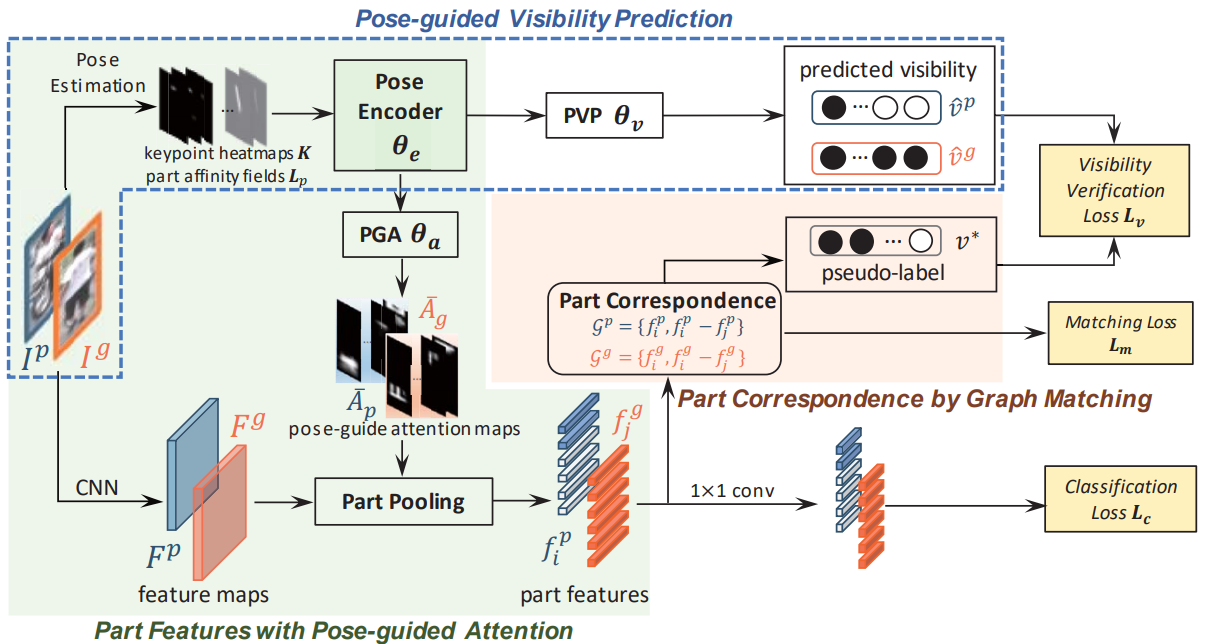
这篇论文提出了一种姿态导向的可见部位匹配(Pose-guided Visible Part Matching,PVPM)网络,通过自主学习的方式直接对图像的可见性进行打分。PVPM包括两个主要的组件姿态导向的部件注意力(Pose-guided Part Attention,PGA)和姿态导向的可见性预测器(Pose-guided Visibility Predictor,PVP)。PVP的训练过程受一组伪标注监督,这一伪标注通过使用图匹配方法求解一个特征对应问题得到。最终两张图像的匹配得分通过将各个部件的距离按照其可见性得分加权聚合得到。
Pose-Guide Visible Part Matching
- PVPM网络的流水线和训练过程如下图所示:
Part Features with Pose-Guide Attention
-
在有所遮挡的情形下,有判别性的部件会显得尤其重要,为了实现这样的区分,PVPM将身体上各个部件的特征通过一个由姿态导向的注意力加权融合。
-
对于一张给定的图像,首先通过一个卷积神经网络提取其外观特征图,接下来通过姿态估计器、姿态编码器和注意力生成器输出一组姿态注意力。
-
在姿态估计这一过程,PVPM使用了OpenPose方法,OpenPose输出一组关键点热力图和部件亲和力场;
-
随后,PVPM通过一个姿态编码器将作为输入嵌入到高阶姿态特征中,这一过程可以被描述为,其中代表编码器的参数;
-
此后,注意力生成器通过一个卷积和紧随其后的Sigmoid函数,生成一组2维堆叠注意力图,这一过程可被描述为。
-
-
注意力图上的每一个元素代表着特征图上的点属于第个部件的度。由于理想情况下各个部件的覆盖区域应该是不重叠且彼此互补的,PVPM通过提取每一个部件特征图上值最大的部分的空间位置,来重新生成了每个部件的注意力图。即
-
最后,每一个部件的特征可以通过对特征图上的各个部件的加权池化来获得
Pose-Guide Visibility Prediction
-
在对人体提取了基于部件的特征之后,对于特征间距离的度量自然需要做部件与部件之间的度量,然而并不是所有的部件在两幅图像中都存在,这时就需要一个预测器来预测部件的可见性。
-
PVPM通过一个包含了全局平均池化、卷积、批归一化和Sigmoid四层的小型网络来预测各部件的可见性,这一过程可被描述为。
-
在这样的前提下,若代表第个部件特征间的余弦距离,probe图像和gallery图像之间的距离可以被描述为
Pseudo-Label Estimation by Graph Matching
-
由于在Ground Truth中各个部件的可见性一般是不能直接得到的,论文作者提出了一种自监督的可见部件检索方法。该方法基于两点前提:
-
只有当某一部件同时在中均可见时,该部件对的相关性才会变高。
-
在同一幅图中有边连接的两个部件之间也呈现高度相关性。
-
-
基于上述考虑,PVPM希望通过估计一个描述两个部件的可见性向量的内积矩阵来估计这一相关性。
-
对于给定的正样本对,通过两张图和来描述,其中的元素和分别代表部件节点上的特征和连接部件的边上的特征。
-
定义二值指示向量代表和之间的匹配度,如果第个部件同时在两张图上出现将被设为1,否则为0。
-
定义亲和力矩阵如下,其中代表的滑动平均值:
- 此时,图匹配问题可以被视作一个整数二次规划问题和一个正则化项,式中代表矩阵的对角线上元素的滑动平均值:
- 通过对上述表达式的最优化,可以得到一个向量,该向量指示着哪些部件在两幅图间是匹配的,这个向量将被用于优化PVP模块。
Loss Function
- PVPM的损失函数一共分为三个部分,可见性部位的预测损失,部件匹配的损失和识别损失,即,其中
Experiments
Conclusion
- 此论文提出了一种姿态导向的可视化部件匹配方法来解决有遮挡的Re-ID问题。PVPM通过一个统一的框架来考虑姿态导向的注意力和部件可见性。与其他方法不同的是,PVPM不是从其他数据源来获得可见性信息,而是通过一种基于图匹配的方法自监督学习。
Paper Information
-
Gao S, Wang J, Lu H, et al. Pose-guided Visible Part Matching for Occluded Person ReID[C]//Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2020: 11744-11752.