李英平Li Yingping

《Transferable, Controllable, and Inconspicuous Adversarial Attacks on Person Re-identification With Deep Mis-Ranking》论文笔记

目录
  1. Introduction
  2. Methodology
  3. Overall Framework
  4. Learning-to-Mis-Rank Formulation For ReID
  5. Learning Transferable Features for Attacking
  6. Controlling the Number of the Attacked Pixels
  7. Perception Loss for Visual Qualit
  8. Objective Function
  9. Paper Information

Introduction

  • 伴随着深度神经网络技术的发展,Re-ID任务得到了很好的发展,然而Re-ID从深度神经网络里得到不仅仅是提升,也继承了深度神经网络中脆弱性。近年来针对深度神经网络的对抗性攻击取得了不错的成果,在图像分类等人物中,已经有很好的方案去欺诈分类器。本文希望通过对抗性攻击完成对基于DNN的Re-ID模型的欺诈。
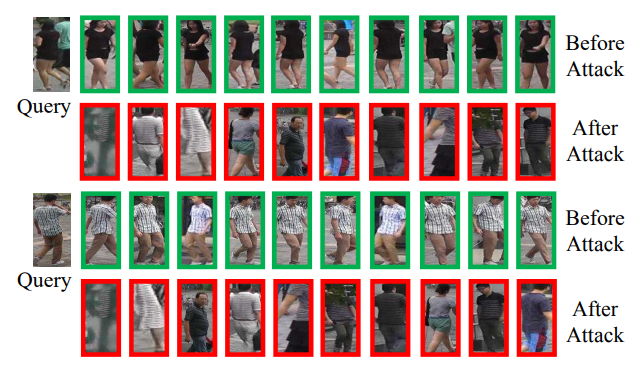
  • 通过探索对现有Re-ID模型的对抗性攻击,可以挖掘出现有的模型的弱点,有利于对Re-ID问题的鲁棒性的提升,是一项很有意义的工作。

  • 由于现实世界中的人物是无穷尽的,且他们不会存在于数据集中。因此,针对Re-ID问题的攻击和对于图像分类等人物的攻击是不一样的,应被视为一个跨域黑箱攻击问题。现有的对抗性攻击方法通常都不具有跨域迁移性,同时,作者期望这样的攻击是隐式的,在不影响图像的感知质量的条件下实现攻击,使人眼不能发觉图像已经过了破坏。

Methodology

Overall Framework

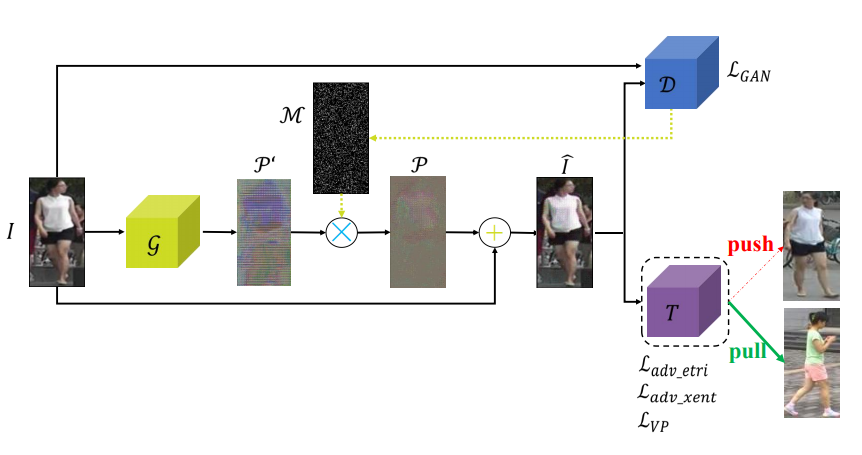
  • 下图展示了网络的基本框架,网络的目标是通过生成器G\mathcal{G}为每一张输入图像I\mathcal{I}生成一组具有欺骗性的噪音P\mathcal{P},进而获得对抗性样本I^\hat{\mathcal{I}},该样本可以欺骗Re-ID系统T\mathcal{T}使其输出错误的结果。

Learning-to-Mis-Rank Formulation For ReID

  • 为了打乱Re-ID系统输出的排序,论文提出了一种新的误排序损失Mis-ranking Loss来攻击Re-ID系统的排序环节。该损失的形式同三元损失类似,但优化方向与三元损失相反,误排序损失希望最小化不匹配样本对之间的距离,同时最大化匹配的样本对之间的距离。该损失函数的形式如下:

Ladv_etri=∑k=1K∑c=1Ck[max⁡j≠kj=1…Kcd=1…Cj∥T(Ick^)−T(Icdk^)∥22−min⁡cs=1⋯Ck∥T(Ick^)−T(Icsk^)∥22+Δ]+\mathcal{L}_{adv\_etri}=\sum_{k=1}^{K}\sum_{c=1}^{C_k}[\max_{\substack{j\ne k\\ j=1\dotso K\\ c_{d}=1\dotso C_j}}\|\mathcal{T}(\hat{\mathcal{I}_c^k})-\mathcal{T}(\hat{\mathcal{I}_{c_d}^k})\|_2^2-\mathop{\min}_{c_s=1\cdots C_k}\|\mathcal{T}(\hat{\mathcal{I}_c^k})-\mathcal{T}(\hat{\mathcal{I}_{c_s}^k})\|_2^2+\Delta]_+

  • 上式中CkC_k代表第kk个ID下的人物图像样本的数量,Ick\mathcal{I}_c^k代表第kk个ID下的第cc张图像样本,csc_s和cdc_d代表同一个ID和不同ID下的样本,Δ\Delta代表边界阈值。

Learning Transferable Features for Attacking

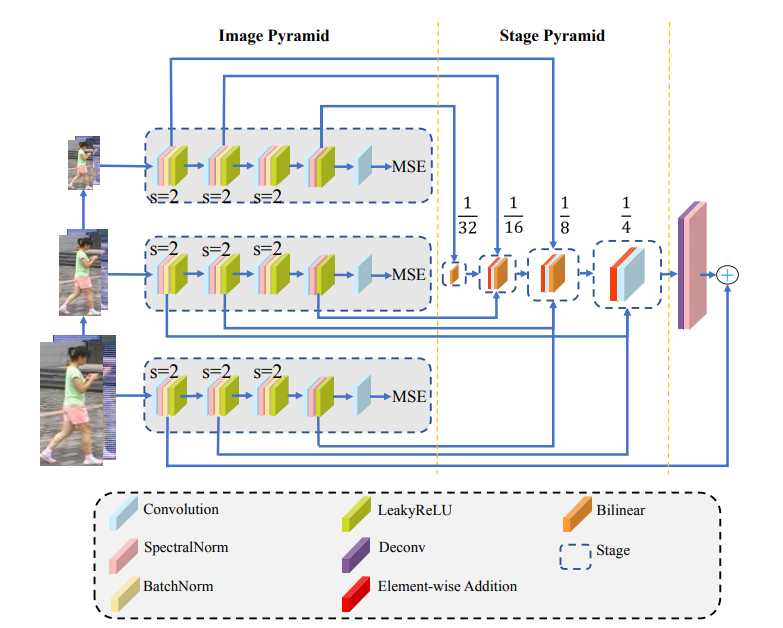
  • 为了提升模型的迁移能力,论文作者设计了一种新型的判别器结构,配合ResNet50的生成器,组成了一个拥有更强的表征学习能力的GAN网络,用于提取通用性更强的特征来实施对抗干扰。

  • 判别器D\mathcal{D}使用了多尺度输入下的多层次特征进行融合,其网络结构如图所示

Controlling the Number of the Attacked Pixels

  • 为了使攻击不易被感知(即,使攻击可以欺骗Re-ID系统,但不易被人类察觉),作者做了两个方面的工作,其中之一是控制被攻击的像素点的个数。

  • 本文对判别器的Softmax输出向量λi,j\lambda_{i,j}通过一个基于Gumbel-Softmax的方式计算特征图上所有像素点的概率分布,掩膜M\mathcal{M}选取概率最高的kk个像素点保留,其余在正向传播中舍弃,以此从生成器输出的初始噪声P′\mathcal{P^\prime}中选择出最终的噪声P\mathcal{P}。

Mij={KeepTopk(pi,j),in forward propagationpi,j,in backward propagationpi,j=exp⁡((log⁡(λi,j+Ni,j))/τ)∑i,j=1H,Wexp⁡((log⁡(λi,j+Ni,j))/τ)M_{ij}=\left\{ \begin{aligned} &\mathcal{KeepTopk}(p_{i,j}),& \text{in forward propagation}\\ &p_{i,j},& \text{in backward propagation} \end{aligned} \right. \\ p_{i,j}=\frac{\exp((\log(\lambda_{i,j}+\mathcal{N}_{i,j}))/\tau)}{\sum_{i,j=1}^{H,W}\exp((\log(\lambda_{i,j}+\mathcal{N}_{i,j}))/\tau)}
  • 式中Ni,j=−log⁡(−log⁡(U)),U∼Uniform(0,1)\mathcal{N}_{i,j}=-\log(-\log(U)),U\thicksim Uniform(0,1),τ\tau是分布的软化参数。

Perception Loss for Visual Qualit

  • 作者为了保证攻击不易察觉所做的另一个工作是引入了一个损失函数来描述所生成图像与原始图像的视觉差异。

  • 受启发于多尺度结构相似性(Multi-Scale-Structure Similarity Index,MS-SSIM),作者提出了感知损失(Perception Loss)LVP\mathcal{L}_{VP},其具体形式如下

L(I,L^)=[lL(I,L^)]αL⋅∏j=1L[cj(I,L^)]βj[sj(I,L^)]γjcj(I,L^)=2σIσI^+C2σI2+σI^2+C2sj(I,L^)=σII^+C3σIσI^+C3\mathcal{L}(\mathcal{I},\hat{\mathcal{L}})=[l_L(\mathcal{I},\hat{\mathcal{L}})]^{\alpha_L}\cdot \prod_{j=1}^{L}[c_j(\mathcal{I},\hat{\mathcal{L}})]^{\beta_j}[s_j(\mathcal{I},\hat{\mathcal{L}})]^{\gamma_j}\\ c_j(\mathcal{I},\hat{\mathcal{L}})=\frac{2\sigma_\mathcal{I}\sigma_{\hat{\mathcal{I}}}+C_2}{\sigma_\mathcal{I}^2+\sigma_{\hat{\mathcal{I}}}^2+C_2}\\ s_j(\mathcal{I},\hat{\mathcal{L}})=\frac{\sigma_{\mathcal{I}\hat{\mathcal{I}}}+C_3}{\sigma_\mathcal{I}\sigma_{\hat{\mathcal{I}}}+C_3}
  • 上式中σ\sigma代表方差或协方差,αL,βj,γj\alpha_L,\beta_j,\gamma_j是各个组件的权重,LL代表图像的尺度级。

Objective Function

  • 除了上文提到的误排序损失Ladv_etri\mathcal{L}_{adv\_etri}和感知损失LVP\mathcal{L}_{VP},网络还受两个损失函数的监督,分别是误分类损失(Misclassification Loss)Ladv_xent\mathcal{L}_{adv\_xent}和GAN损失LGAN\mathcal{L}_{GAN},四种损失经过加权得到总的损失L\mathcal{L}。 L=LGAN+Ladv_xent+ζLadv_etri+η(1−LVP)\mathcal{L}=\mathcal{L}_{GAN}+\mathcal{L}_{adv\_xent}+\zeta\mathcal{L}_{adv\_etri}+\eta(1-\mathcal{L}_{VP})

  • 误分类损失在形式上是一个带有标签平滑的交叉熵损失,唯一的区别在于对于标签的编码形式,常规的分类任务会将标签编码成真实类别为1其余项为0的One-hot编码,这里的编码形式是使正确类别为0,其余类别为1K−1\frac{1}{K-1},KK是总的类别数。S(⋅)\mathcal{S}(\cdot)代表log-softmax函数,δ\delta是平滑因子。 Ladv_xent=−∑k=1KS(T(I^))k((1−δ)1arg⁡min⁡T(Ik)+δvk)\mathcal{L}_{adv\_xent}=-\sum_{k=1}^{K}\mathcal{S}(\mathcal{T}(\hat{\mathcal{I}}))_k((1-\delta)\mathbf{1}_{\arg\min\mathcal{T}({\mathcal{I}}_k)}+\delta v_k)

  • GAN损失被定义为 LGAN=E(Icd,Ics)[log⁡D1,2,3(Icd,Ics)]+EI[log⁡(1−D1,2,3(I,I^))]\mathcal{L}_{GAN}=\mathbb{E}_{(I_{c_d},I_{c_s})}[\log\mathcal{D}_{1,2,3}(I_{c_d},I_{c_s})]+\mathbb{E}_{\mathcal{I}}[\log(1-\mathcal{D}_{1,2,3}(\mathcal{I},\hat{\mathcal{I}}))]

Paper Information